Técnico
Noindex, nofollow y disallow: qué hace cada uno de verdad
Se confunden constantemente y hacen cosas distintas: uno impide entrar, otro impide guardar y otro no transmite valor. Combinarlos mal deja páginas atrapadas.
- Lectura 10 min
- Publicado
- Jesús Iturbide consultor SEO
- Cómo reviso estos artículos
En corto
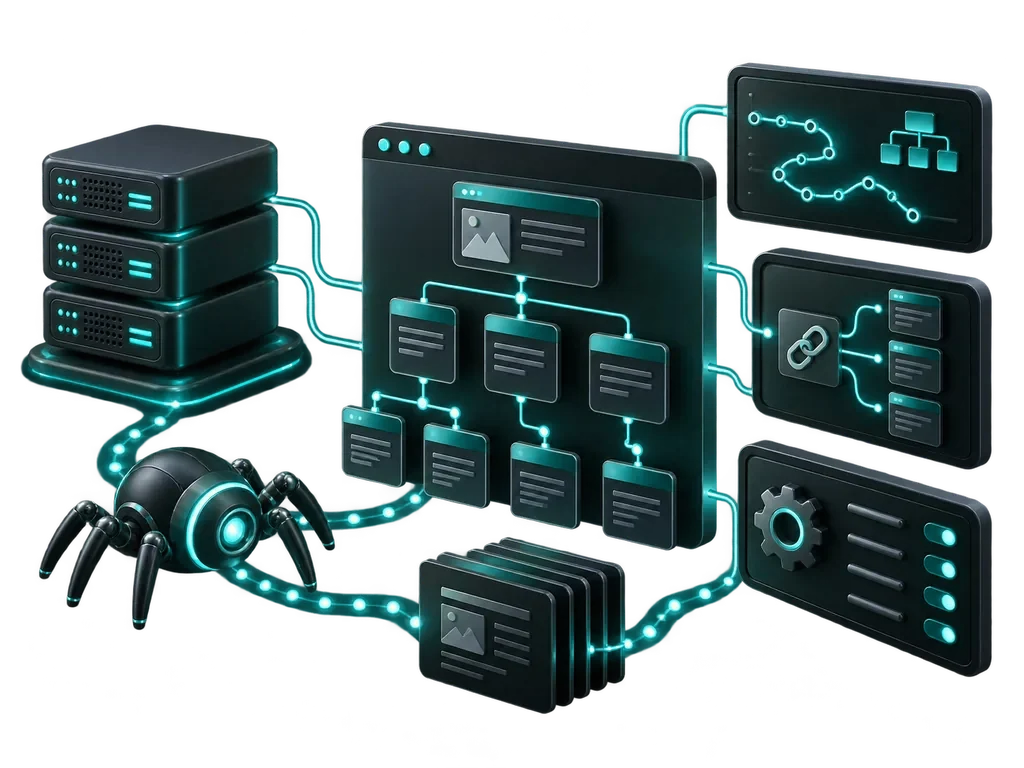
Disallow impide entrar a leer la página; noindex pide que no se guarde en el índice; nofollow dice que no se siga un enlace ni se le transmita valor. Son tres cosas distintas y la confusión más cara es combinar las dos primeras: si bloqueas el acceso, nadie puede leer el noindex, y la página se queda atrapada.
Del enlace al resultado
- Un enlace lleva a la página
- Se descarga y se lee
- Entra en el índice
- Compite por salir
Son tres instrucciones que se nombran juntas, se confunden a diario y producen algunos de los problemas más difíciles de diagnosticar de una web, porque el síntoma no se parece a la causa.
Entender qué hace cada una lleva cinco minutos y ahorra meses de páginas que no se indexan sin que nadie sepa por qué.
Las tres, una por una
| Instrucción | Dónde se pone | Qué hace |
|---|---|---|
| Disallow | En el fichero de robots | Pide no entrar a leer esa ruta |
| Noindex | En la cabecera de la página | Pide no guardar la página en el índice |
| Nofollow (enlace) | En un enlace concreto | No sigue ese enlace ni le transmite valor |
| Nofollow (página) | En la cabecera de la página | No sigue ninguno de sus enlaces |
El error clásico: bloquear y esperar que se desindexe
Es la combinación que más veces veo y la que más desconcierta: se pone la página en noindex, se comprueba que sigue apareciendo y entonces se añade también un disallow «para asegurar». El resultado es el contrario: al bloquear el acceso, nadie puede volver a leer el noindex, así que la página se queda como está, a veces durante años.
La secuencia correcta es al revés: primero se deja acceso libre y se pone el noindex; se espera a que se lea y la página desaparezca del índice; y solo después, si se quiere ahorrar rastreo, se puede añadir el bloqueo.
Qué usar en cada caso
Página que no debe aparecer en resultados
Noindex, con acceso permitido. Es el caso de gracias, carritos, áreas privadas o resultados de búsqueda interna.
Sección enorme que no aporta y consume rastreo
Disallow, una vez que ya no está indexada. Combinaciones de filtros, por ejemplo.
Enlace patrocinado o de usuario
Los atributos específicos para publicidad y para contenido generado por usuarios, o nofollow.
Página duplicada de otra
Ninguna de las tres: canónica, o redirección si una debe desaparecer.
Contenido privado de verdad
Contraseña o control de acceso: ninguna de estas instrucciones protege nada.
Lo que ninguna hace
El caso raro: bloqueada e indexada igual
Ocurre y despista mucho: una página bloqueada por el fichero de robots puede aparecer en los resultados, sin descripción, con un texto que dice que no hay información disponible. Pasa cuando hay enlaces apuntando a ella: se conoce su existencia por esos enlaces, aunque no se haya podido leer.
La solución es la de siempre: quitar el bloqueo, dejar que se lea el noindex, esperar a que salga del índice, y después decidir si se vuelve a bloquear.
Lo que hacen con los enlaces
Cómo se comprueba lo que tienes
Se abre el código fuente de la página y se busca la etiqueta de robots en la cabecera. Se abre el fichero de robots del dominio en el navegador y se lee entero. Y se usa la herramienta de inspección de Search Console sobre una dirección concreta, que dice si está bloqueada, si tiene noindex y por qué no está indexada.
Con esas tres comprobaciones se resuelve prácticamente cualquier caso de este tipo en diez minutos.
Qué usar y qué no
Un caso: dos años atrapada
Los recursos bloqueados, el daño invisible
Hay una variante de este problema que no afecta a páginas sino a los ficheros que las hacen funcionar, y que se cuela en muchísimos ficheros de robots heredados.
Bloquear las carpetas donde viven las hojas de estilo, los guiones o las imágenes parece una limpieza razonable: total, esas rutas no son páginas y no interesa que se indexen. El efecto es el contrario del que se busca. Un buscador necesita cargar esos recursos para ver la página como la ve una persona: si no puede, la evalúa a medias, puede no entender la disposición en móvil y en algunos casos ni siquiera ve el contenido que carga un guion.
Es una herencia de reglas antiguas que se siguen copiando de web en web. Se detecta con la herramienta de inspección, que muestra cómo se ha visto la página y avisa de los recursos que no ha podido cargar, y se corrige simplemente permitiendo el acceso a esas carpetas.
Y la regla general que evita esto y muchos otros líos: el fichero de robots se escribe para bloquear lo que genera direcciones inútiles, no para esconder cosas ni para «ordenar». Cada línea debe tener un motivo que alguien pueda explicar, y si nadie recuerda por qué está ahí, probablemente sobra.
Qué mediría
En el informe de páginas, cuántas hay bajo el motivo de bloqueadas por robots y cuántas bajo el de excluidas por noindex. La primera cifra alta, con páginas que querías desindexar, es la señal exacta de este error, y se corrige en una tarde.
Preguntas frecuentes
¿Cuál es la diferencia entre disallow y noindex?
Disallow, en el fichero de robots, pide no entrar a leer esa ruta. Noindex, en la cabecera de la página, pide no guardarla en el índice. Actúan sobre fases distintas: una sobre la lectura y otra sobre el almacenamiento, y por eso no son intercambiables.
¿Por qué mi página con noindex sigue apareciendo?
Casi siempre porque además está bloqueada en el fichero de robots: al impedir el acceso, nadie puede leer el noindex, así que la página se queda como está. La solución es quitar el bloqueo, dejar que se lea el noindex, esperar a que desaparezca y solo después volver a bloquear si interesa.
¿El fichero de robots protege contenido privado?
No: es una petición pública y voluntaria, se puede leer desde el navegador y listar ahí una carpeta es la forma más rápida de señalar dónde está. El noindex tampoco protege nada. Si un contenido no debe verse, se protege con contraseña o con control de acceso en el servidor.
¿Debo poner nofollow en enlaces internos?
No: llenar la web de enlaces internos con nofollow para «canalizar el valor» es una táctica antigua que hoy no aporta y complica el mantenimiento. El nofollow y sus atributos específicos son para enlaces patrocinados y para contenido generado por usuarios, que es donde tienen sentido.
¿Qué uso para páginas duplicadas?
Ninguna de las tres: para duplicados se usa la etiqueta canónica, señalando cuál es la versión buena, o una redirección permanente si una de ellas debe desaparecer. Poner noindex a un duplicado es una solución tosca que además puede quitarte la versión equivocada.
Qué se bloquea, qué se desindexa y qué se redirige lo decido por tipos de página en SEO técnico. En una tienda, donde los filtros multiplican las direcciones, esa decisión se toma dentro del SEO para ecommerce. Si tienes páginas que no aparecen o que aparecen sin querer, el diagnóstico está en cómo saber si Google tiene indexada tu web y en por qué tu web no aparece en Google: las siete causas que más veo. El repaso completo, en una auditoría SEO.
Si te está pasando
La primera llamada no cuesta nada y suele bastar para saber si tiene arreglo. Si tu caso no es para mí, te lo digo.